
はじめに
2012年のMac miniに、Hermes Agentを住まわせた。
といっても、Hermes Agentを動かすこと自体が目的だったわけではない。
このMac miniは家でほぼ常時稼働している。Linux Mintを入れてDockerを動かしているが、さすがに今どきのLLMを動かして何かをさせるような計算能力はない。
一方、手元にはThinkPad P14s Gen 7 AMDがある。
こちらは64GB RAMを積み、Ryzen AI 9 HX PRO 470のXDNA2 NPU上で、Lemonade + FastFlowLMを使ってQwen3.6 35B MoEを動かしている。
そこで思った。
Agentが常駐するマシンと、LLMが推論するマシンは、同じである必要がないのではないか。
Hermes AgentをMac miniへ常駐させ、考える必要があるときだけP14sのNPUを使わせてみることにした。
検証環境
| 役割 | 構成 |
|---|---|
| Agent Runtime | Mac mini (2012) / Linux Mint / Docker / nousresearch/hermes-agent:latest |
| Inference Node | ThinkPad P14s Gen 7 AMD / 64GB RAM / Ryzen AI 9 HX PRO 470 / XDNA2 NPU |
| Inference Stack | Lemonade 127.0.0.1:13305 → FastFlowLM 127.0.0.1:8001 → qwen3.6-moe-35b-a3b-FLM |
| Network | Tailscale / Tailscale Serve |
| 検証日 | 2026-09-22 |
Hermes Agentは検証時に latest タグを使った。特にDashboardとWeb backendは仕様が変わり得るため、再現するならイメージタグまたはダイジェストを固定したほうがよい。
Agent RuntimeとInference Nodeを分ける
最終的な構成はこうなった。

Mac miniはAgent Runtimeである。
24時間そこにいて、TelegramやDashboardからの入口を持ち、SessionやMemory、Skills、Toolsなどを管理する。
LLMの推論はしない。
P14sはInference Nodeである。
LemonadeのOpenAI互換APIをTailscale経由でMac miniへ提供し、Hermesから要求されたときにQwen3.6を実行する。
役割を分けてみると、これは意外なほど普通に動いた。
localhostのLLMをTailscaleへ投影する
P14sのLemonadeは 127.0.0.1:13305 で動かしている。
FastFlowLMも 127.0.0.1:8001 のままである。
LAN全体へlistenさせる必要はない。
代わりにTailscale Serveを使った。
tailscale serve --bg --tcp=13305 tcp://localhost:13305構造としてはこうなる。

Inference Server自身はlocalhost以外へlistenさせない。
Tailscaleが必要な入口だけをtailnetへ投影する。
Mac miniから /v1/models を取得し、さらに /v1/chat/completions を呼んで pong が返った。
まずInferenceの経路が開通した。
HermesにQwen3.6を使わせる
Mac miniへHermes AgentをDockerで導入した。
Custom Endpointとして指定したのは、P14sのLemonadeである。設定値の要点は次の通り。
Base URL: http://<P14sのMagicDNS名>:13305/v1
Model:    qwen3.6-moe-35b-a3b-FLM
Hermes CLIから環境を調べるよう依頼すると、Qwen3.6がtool callを生成した。
HermesがMac mini側のコンテナでterminal toolを実行する。
結果がP14sへ返る。
Qwen3.6がその結果を読んで、最終回答を生成する。
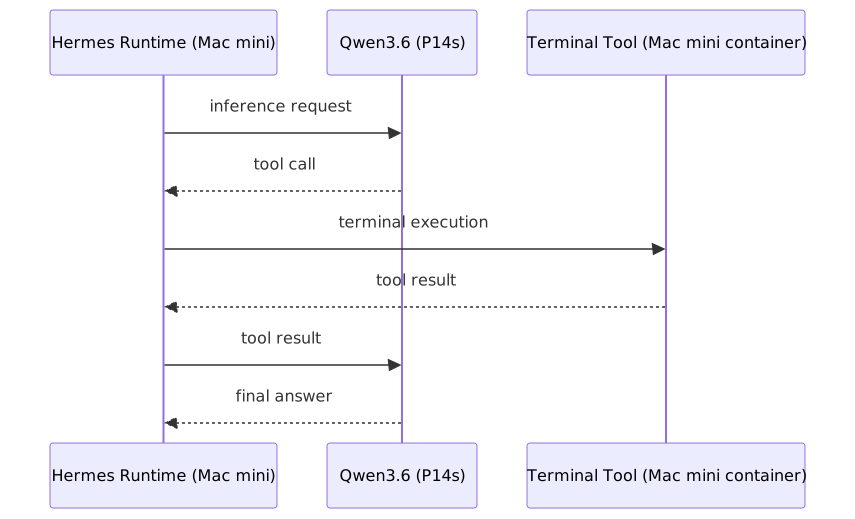
ここで少し面白くなった。
「ローカルLLMが動いた」のではない。
別のマシンで動いているローカルLLMが、Mac miniに常駐しているAgentのToolを使って仕事をした。
Agent RuntimeとInference Nodeは、本当に別々でよかった。
Telegramから話しかける
次にHermes Gatewayを起動してTelegram Botを接続した。
ここではToolの権限を分けた。
CLIではTerminal、File Operations、Code Executionなどを使える。
一方、Telegramではそれらを無効にし、会話、Web Search、Vision、Memory、Planningなどを中心にした。
スマートフォンから気軽に触れる入口に、任意のコマンド実行権限まで与える必要はない。
Telegramからメッセージを送る。

返事が来た。
ここまで来ると、ローカルLLMの実験というより「家にAgentが一匹住み始めた」感じがしてくる。
Dashboardを出そうとしたら怒られた
HermesにはWeb Dashboardもある。
最初は単純に考えた。
コンテナ内では 0.0.0.0:9119 にbindし、Docker側でMac miniの 127.0.0.1:9119 だけへpublishすればいい。
ところがHermesは起動を拒否した。
非loopbackへbindするならDashboardの認証が必要で、認証providerが存在しない状態ではfail closedするようになっていた。
そこでDashboardコンテナをhost networkへ変更し、Hermes自身を 127.0.0.1:9119 にbindした。
localhostからは表示できた。
では、これをTailscale Serveでtailnetへ出せばいい。

今度は、
Invalid Host header
と怒られた。
認証を迂回せず、Hermesの境界に乗る
ここからHermes自身のコードを読んだ。
Dashboardはbound hostだけでなく、設定された dashboard.public_url のhostnameを許可する。そこで、Tailscale Serveが提供するHTTPS URLを設定した。
dashboard:
  public_url: "https://<Mac-miniのtailnet FQDN>"
ただし外部の public_url を宣言すると、Dashboardの認証gateも有効になる。
つまり、Host validationだけ都合よく通して認証を無効化する構成にはならない。
それなら、迂回しないことにした。
Hermesが持っているBasic Authを使う。
対話セットアップでUsernameとPasswordを設定すると、Passwordは平文では保存されずscrypt hashになった。
さらにsession署名用のsecretも生成される。
最終的には、

となった。
LANへDashboardを直接公開していない。
Tailscale Funnelも使っていない。
Hermes自身のHost validationも認証gateも無効化していない。
少し遠回りしたが、この状態でDashboardを拝めたときはなかなか気持ちがよかった。
検索できても、記事を読めるとは限らない
次にWeb Search / Extractを試した。
HermesはDuckDuckGo経由でニュースを検索できた。
ところが、URLの本文を取得させようとすると失敗した。
原因は単純で、ddgs はSearch backendであってExtract backendではなかった。
そこで設定を分けた。
web:
  backend: ddgs
  extract_backend: firecrawl
もう一度試す。
https://example.com の本文から「Example Domain」を取得できた。
実際のニュースページでも抽出できた。
web.extract_backend を firecrawl に変更すると、FirecrawlのAPIキーを明示的に設定していない環境でも web_extract は成功した。現在のHermesにはkeyless経路などが用意されているため、この挙動自体は不自然ではない。なお、この実行で実際に利用された経路まではログから特定していない。
これで、

までできるようになった。
検索スニペットだけを眺めてニュースを語る状態から、一歩進んだ。
35Bは、まあ遅い
もちろん問題もある。
Qwen3.6 35B MoEは賢いが、Agentとして使うと普通に遅い。
20秒以上考え込むこともあるし、複数回のtool callingを含むタスクなら分単位になる。
ただし、ここで比較したいのは単純なtok/sではないと思っている。
今後9Bクラスなどの軽量モデルへ交換して、
| 指標 | 見たいこと |
|---|---|
| Task Completion | タスクを最後まで完了できるか |
| Tool Call Failure | tool callの生成・実行・解釈で失敗しないか |
| Loop Count | 完了までに何往復のAgent loopが必要か |
| Wall-clock | 利用者が待てる実時間に収まるか |
| Evidence Discipline | 検索スニペットだけで断定せず、本文・一次情報・矛盾を扱えるか |
あたりを比べてみたい。
最も賢いモデルを使うのではなく、常駐Agentの仕事を必要な品質で終わらせられるモデルを使うという選択肢がある。
そしてInference Modelを交換しても、Hermes側のMemory、Skills、Tools、Cron、Sessionはそのまま残る。
ここにもRuntimeとInferenceを分離した意味がある。
さて、こいつに何をさせようか
環境が一通り完成したので、試しになにか仕事を振ってみよう。
試しに、毎朝のニュース配信にしてみようか。
よくあるニュースランキングでは面白くないので、
自分が現在触っているものとの接点でニュースを選ばせる、というのはどうだろう。
該当するニュースがなければ、水増ししなくていい。
「何を自分にとって重要と判断するか」はSkillへ置く。
定刻になったらCronがそのSkillを使って仕事を始める。
ここまでやれば、Hermesを常駐させた意味が出てくる。
Agentの本体はどこにあるのか
今回いちばん面白かったのは、Hermes Agentそのものではなかった。
Agent RuntimeとInferenceを分離してみると、Agentの境界が少し違って見えてきた。
Qwen3.6は交換できる。
明日は9Bになるかもしれないし、別のモデルになるかもしれない。
一方で、
- Memory
- Skills
- Rules
- Tools
- Session
- Cron
- 外部サービスとの接続
はRuntime側へ残る。
もちろんモデルを弱くすれば、同じSkillを同じ品質で実行できるとは限らない。
Inferenceの能力は重要である。
それでも、Agentの仕事の仕方や継続性のすべてをモデルの重みの中へ押し込む必要はない。
何を証拠として扱うか。
どういう順番で調べるか。
何をしてはいけないか。
そういう「仕事の仕方」をモデルの外側へ残す。
モデルは、その仕事を遂行するための推論器として使う。
今回Hermesを触って、その構造が常駐Agentでもかなり具体的に見えるようになった。
Hermes Agentを入門したかったわけではない。
余っていた常時稼働機と、手元のNPUと、Tailscaleをつないでいたら、いつの間にか自分専用の常駐Agentができていた。
たぶん面白くなるのは、ここからである。
cover image: unsplash